Spark入门指南:核心概念与快速上手
Apache Spark 是当前最流行的大数据处理引擎之一,以其内存计算和统一的技术栈著称。本指南将带你了解 Spark 的核心概念、运行架构以及快速上手方法,为后续深入学习 Spark SQL、Streaming 等组件打下基础。
为什么选择 Spark?
- ✓ 内存计算,速度比 MapReduce 快 100 倍
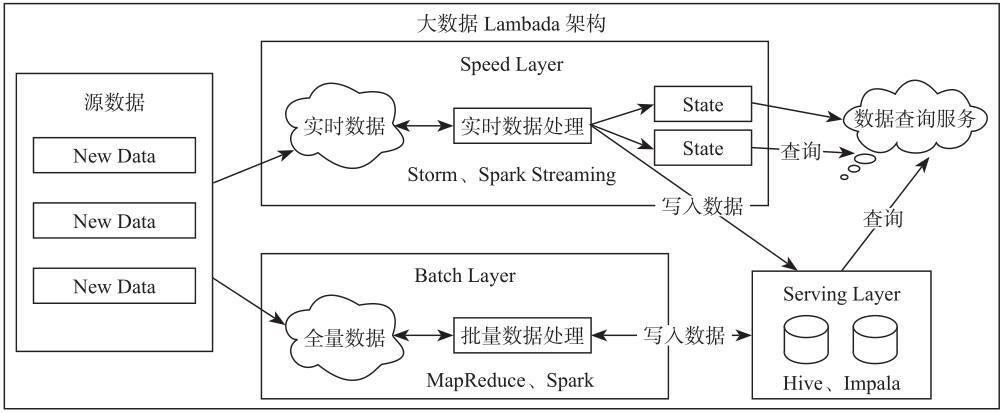
- ✓ 统一技术栈,支持批处理、流计算、机器学习、图计算
- ✓ 丰富的 API,支持 Scala、Java、Python、R
- ✓ 与 Hadoop 生态无缝集成
Spark 核心架构
Spark 采用主从架构,核心组件包括 Driver、Cluster Manager 和 Executor。Driver 负责解析应用逻辑并调度任务,Executor 负责执行具体计算任务。
- Driver:运行应用的 main() 方法,创建 SparkContext。
- Cluster Manager:负责资源分配,如 Standalone、YARN、Mesos。
- Executor:在工作节点上执行任务,缓存数据。
Spark 核心组件对比
| 组件 | 说明 | 适用场景 |
|---|---|---|
| Spark Core | 基础引擎,提供 RDD 和任务调度 | 通用数据处理 |
| Spark SQL | 结构化数据查询,支持 SQL 和 DataFrame | 数据仓库、ETL |
| Spark Streaming | 流式数据处理,微批模式 | 实时数据管道 |
| MLlib | 机器学习库 | 分类、回归、聚类 |
| GraphX | 图计算框架 | 社交网络分析 |
快速上手:WordCount 示例
下面是一个使用 Spark Shell 运行 WordCount 的简单示例,帮助你快速体验 Spark 的编程模型。
// 启动 Spark Shell
spark-shell

// 读取文件
val textFile = sc.textFile("hdfs:///input/words.txt")

// 切分单词并计数
val counts = textFile.flatMap(line => line.split(" "))
  .map(word => (word, 1))
  .reduceByKey(_ + _)

// 输出结果
counts.saveAsTextFile("hdfs:///output/wordcount")
通过这个例子,你可以了解 RDD 的创建、转换和行动操作。更多详细教程请参考大象教程的 Spark 系列文章。
常见问题(FAQ)
Spark 与 Hadoop 的关系是什么?
Spark 可以独立运行,也可以与 Hadoop 集成,使用 HDFS 存储数据,并借助 YARN 进行资源调度。Spark 常被看作 Hadoop MapReduce 的替代方案,但两者互补。
学习 Spark 需要什么基础?
建议先掌握 Java 或 Scala 基础,了解 Linux 基本操作,并对 Hadoop 生态有一定认识。大象教程提供了从零开始的 Spark 学习路径。
Spark 支持哪些编程语言?
Spark 原生支持 Scala,同时提供 Java、Python 和 R 的 API。你可以选择最熟悉的语言进行开发。
相关阅读
继续学习
掌握 Spark 基础后,你可以进一步学习 Spark SQL、Spark Streaming 等高级组件。大象教程提供了完整的 Spark 学习路线,助你成为大数据处理专家。